Обо мне · SERM и GERM
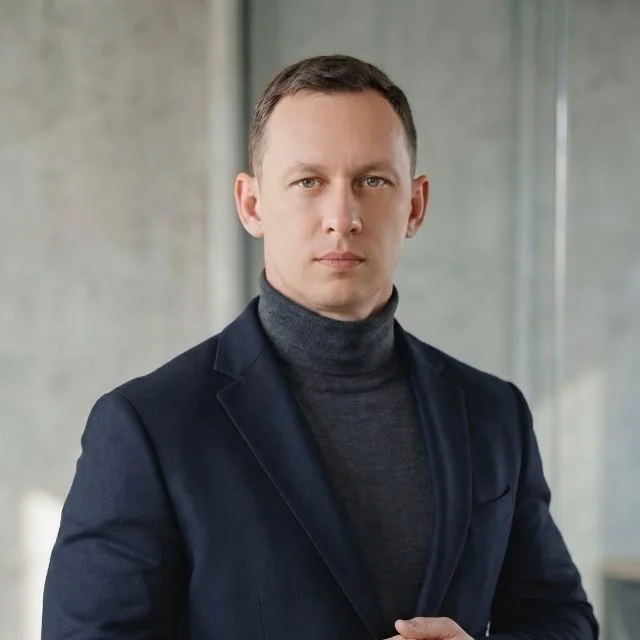
Евгений Цыплаков — специалист по управлению репутацией
Инженер репутации в поиске и ИИ. Я строю то, что показывает поисковая выдача и что говорят ИИ-системы о человеке или компании, до того, как те, кто принимает решения, вводят имя в поиск.
Before you share any details, we sign a mutual NDA — it protects both sides from this moment forward. Three steps, two minutes.
- 1
-
2
Fill in your name and today's date, then save Any browser or PDF viewer works — no special software needed.
-
3
Attach the signed PDF and send it below I'll confirm receipt and deliver your name snapshot within 48 hours.
Вы в правильном месте, если:
Кого-то ищут перед тем, как принять решение, и вы не контролируете, что они находят.
Инвестор перед звонком. Кандидат перед собеседованием. Партнёр перед подписанием. Консульский офицер перед визовым решением. Любой из них вводит имя в Google или спрашивает у ИИ. То, что они получают в ответ, никто на вашей стороне не готовил.
В поисковой выдаче есть что-то, что мешает, и вы не можете это контролировать.
Старая статья, которая уже не отражает реальность. Человек с похожим именем и другой историей. Негативный отзыв на первой строчке. Упоминание в контексте, который потерял актуальность много лет назад.
Вы готовите человека или компанию к важной проверке, а репутационный слой не готов.
Сделка, где покупатель проверяет всё. Назначение на должность, где совет директоров гуглит кандидата. Визовая петиция, где офицер ищет имя до решения. Выход на новый рынок, где вас ещё никто не знает.
ИИ отвечает о вас или вашей компании неточно.
Путает с другим человеком. Называет старую должность или компанию. Упоминает в неверном контексте. Модель не придумывает; она усредняет то, что проиндексировано. Если источники неточные, ответ неточный.
Достижения есть, но поисковая выдача этого не показывает.
Человек сильный, результаты есть, публикации есть или их нет. Но поиск показывает либо ничего, либо что-то не то. Те, кто принимает решения, видят картину, которая не соответствует реальности.
Метод: обратный инжиниринг
Я не начинаю с контента. Я начинаю с конца. Сначала задаю, что должна показывать выдача и что должен отвечать ИИ, когда проект завершён. Потом иду назад — к минимальному набору сигналов, который производит именно это состояние. Каждый шаг ниже идёт в этом порядке.
Проектирую финальное состояние выдачи
Какой актив занимает какую позицию на первой странице. Что показывает панель знаний. Что предлагает автодополнение. Что утверждает ИИ на прямой вопрос.
Проектирую эмоцию, которую должен получить проверяющий
Какой вывод должен сделать инвестор, офицер или комитет в первые десять секунд просмотра страницы.
Готовлю тезисы, которые должен закрепить каждый актив
Не «что-то позитивное». Конкретные утверждения, каждое привязано к позиции в целевом состоянии.
Готовлю структуру каждого материала
Интервью, профиль, экспертный комментарий — у каждого своя структура под свою роль.
Готовлю текст
Пишут профессиональные журналисты. Материал, который принимают редакторы и которому доверяют читатели, а не копирайтерский наполнитель.
Снабжаю SEO-оптимизацией
Заголовок, мета, внутренняя структура, расстановка ключевых слов. Читается и людьми, и машинами.
Подбираю площадку
По её авторитетности в глазах поисковых систем и ИИ, соответствию аудитории и техническим параметрам. Не по узнаваемости логотипа.
Размещаю, индексирую, проверяю ранжирование
По одному активу за раз. Каждый проверяется на индексацию и ранжирование, прежде чем размещается следующий.
Мониторю позицию и попадание в данные ИИ
Отслеживаю, как каждый актив держит позицию, цитируется ли он и попадает ли в обучение и выборку ИИ.
Поэтому прогноз и держится. Когда целевое состояние задано заранее, а каждый актив проверен до следующего, первая страница получается такой, как спроектирована. Прогноз и реальность совпадают на 95%.
Четыре механики в работе
Каждый проект строится на четырёх механиках. Они работают вместе; их состав зависит от задачи.
Вытеснение
На первой странице десять результатов. Негативный нельзя удалить, но девять управляемых активов над ним сдвигают его на страницу два, куда при проверке никто не заходит.
Ассоциации
Поисковики понимают, что значит имя, по словам, компаниям и проектам, рядом с которыми оно встречается. Закрепляешь новое соседство — система отдаёт приоритет новому паттерну над старым.
Устранение путаницы
Когда есть однофамильцы или варианты написания, алгоритм путает людей. Усиление других носителей имени делает статистически ясным, что их несколько, и выдача разделяется.
Консенсус источников
Языковые модели не ранжируют страницы; они усредняют источники. Корпус согласованных, авторитетных, актуальных источников заставляет модель утверждать верный ответ, а не гадать.
Сроки: что и когда ожидать
очему 8–9 месяцев? Поисковые индексы обновляются ежедневно, поэтому актив может выйти в топ за недели. Языковые модели обновляют обучение и выборку раз в несколько месяцев. Чтобы корпус вошёл в обучающие данные и пережил цикл обновления, работа охватывает один-два таких цикла. Срок задаётся инфраструктурой провайдеров моделей, а не интенсивностью работы.
Что это покрывает, а что нет
Покрывается
- Поисковая выдача в любой юрисдикции, где работает Google
- Ответы любых публичных языковых моделей (ChatGPT, Perplexity, Gemini, Claude)
- Репутация бренда и личности на публичной поверхности интернета
Не покрывается: KYC / AML
KYC и AML-проверки берут данные из закрытых баз: госреестры, судебные системы, санкционные списки, World-Check, LexisNexis. Они не обращаются к публичному интернету, поэтому работа с публичной поверхностью на них не влияет. Устойчивость там требует юридического структурирования и планирования юрисдикций — это работа для юристов и финансистов, а не для инженера репутации.
Отчётность
Самый сильный страх перед началом проекта: «Что если мы получим ерунду и останемся крайними?"
Я снимаю этот страх отчётностью. Вы всегда знаете, что происходит.
Ежемесячный отчёт включает:
- Снимок текущего состояния. Скриншот первой страницы поисковой выдачи на сегодня. Что занимает каждую позицию. Что изменилось с прошлого месяца.
- Динамика. Как двигались позиции. Какие активы набрали вес. Какие потеряли. Почему.
- Объём выполненной работы. Сколько материалов опубликовано. Где. Ссылки на каждый опубликованный материал.
- Процент выполнения проекта. Где мы находимся относительно целевого состояния. Что ещё предстоит построить.
- Инциденты и как они купированы. Если в выдаче появилось что-то неожиданное, что это было, как я это локализовал и что сделано, чтобы предотвратить это в будущем.
Вы не ждёте в темноте. Вы видите состояние проекта на каждом шаге.
Background
Я пришёл из коммерческого SEO. С 2006 по 2019 год я продвигал сайты по высококонкурентным запросам: финансы, недвижимость, интернет-магазины, в основном на русскоязычных рынках. В такой среде быстро учишься: какой актив вытеснит конкурента из топа, какой встанет рядом с ним, как собрать первую страницу так, чтобы она держалась под давлением.
Я закончил Саратовский государственный технический университет по специальности инженер-программист. Возможно, поэтому я никогда не рассматривал репутацию как задачу коммуникаций. Систему не чинят красивыми словами. Нужно изменить то, что она видит, и то, как она это взвешивает.
В 2019 году я понял, что та же механика работает для имён людей. Я начал применять это к репутации: перед стартом прогнозировать, что покажет первая страница через год, и строить именно это. Не публиковать контент и надеяться. Сейчас прогноз и реальность совпадают на 95%.
С кем я работаю
Я работаю на пересечении русскоязычного и западного мира. Типичная ситуация: человек с русскоязычным бэкграундом готовится к проверке в западном контексте.
Раунд инвестиций, где инвестор гуглит каждого основателя. Назначение в совет директоров, где комитет проверяет каждого кандидата. Визовая петиция, где иммиграционный офицер ищет имя до интервью. Найм на топ-позицию, где HR и нанимающий менеджер оба ищут кандидата.
Проблема структурная. Google смешивает его с однофамильцами. ИИ собирает ответ из документов о других людях. Первая страница не показывает, кто он на самом деле. В важных решениях на эту первую страницу чаще всего и смотрят.
С кем я работаю:
Основатели и CEO перед раундами инвестиций или сделками. Руководители перед назначением в совет директоров или на топ-позиции. Люди, работающие с иммиграционными адвокатами над визами EB-1A, EB-2 NIW или O-1, где одна неверно атрибутированная поисковая выдача может перечеркнуть месяцы юридической работы. Компании, чьё руководство проходит регуляторную проверку или due diligence.
Там, где в деле участвует адвокат, я работаю через него. Адвокат остаётся точкой контакта на всём протяжении. Прямой связи с клиентом без одобрения адвоката нет. Работа конфиденциальна по умолчанию.
Евгений Цыплаков — инженер поисковой и ИИ-репутации (SERM / GERM). Инжиниринг онлайн-репутации: то, что поисковые системы и ИИ-платформы говорят о вашем имени. Этот профиль не следует путать с другими специалистами — тёзками по имени Евгений Цыплаков.
Хотите увидеть, как это выглядит для вашего имени?
Запросите снимок имени: что показывают поисковики и ИИ-системы сейчас и что можно изменить.
Before you share any details, we sign a mutual NDA — it protects both sides from this moment forward. Three steps, two minutes.
- 1
-
2
Fill in your name and today's date, then save Any browser or PDF viewer works — no special software needed.
-
3
Attach the signed PDF and send it below I'll confirm receipt and deliver your name snapshot within 48 hours.